SHAP 중요도와 AUC가 원인 설명은 아닌 이유
성인 11,809명의 후향 예측 연구를 바탕으로 AUC 0.78과 SHAP 특성 중요도가 모델 성능과 예측 기여를 뜻할 뿐 인과관계나 개인 확정을 뜻하지 않는 이유를 설명합니다.
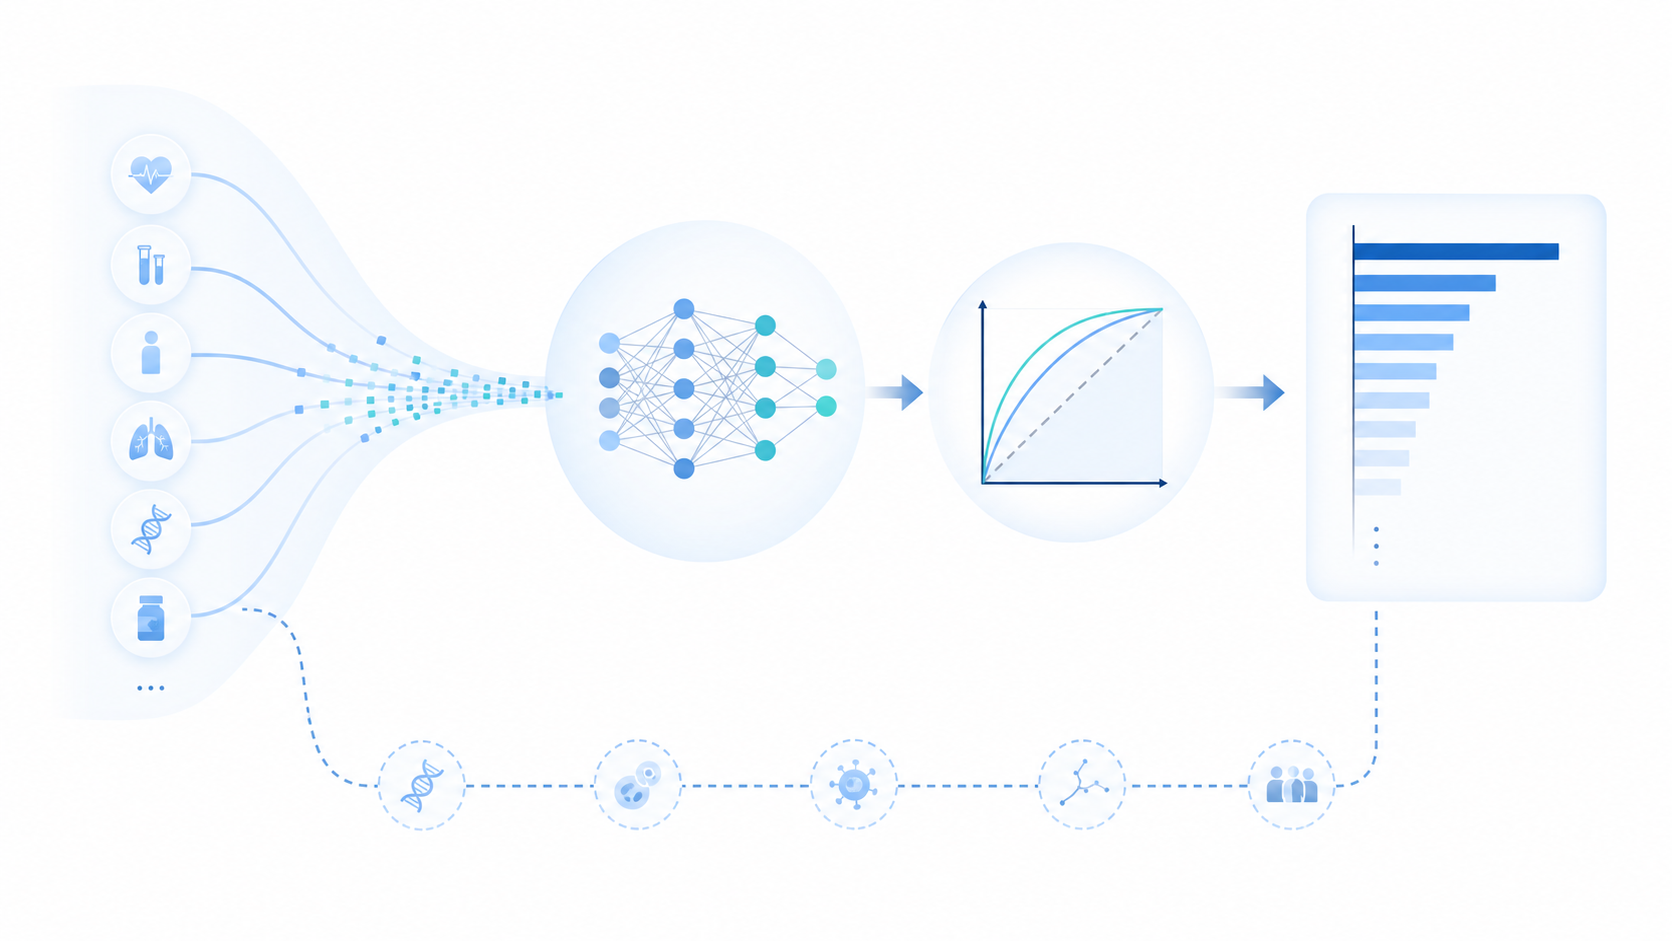
예측모델의 AUC가 높고 SHAP 분석에서 한 변수가 가장 중요하게 나타났다면, 그 변수가 질병 진행의 원인이라고 말할 수 있을까요? 결론부터 말하면 예측과 인과는 다른 질문입니다. 미시간 남동부 8개 의료기관의 후향 자료를 이용한 연구는 전당뇨 범위의 당화혈색소가 2년 연속 기록된 성인 11,809명을 구성하고 1년 안에 연구의 당뇨 기준에 도달하는지를 예측했습니다. 연구 기록
후향 예측 코호트는 무엇을 하는가
후향 연구는 이미 쌓인 기록을 이용해 과거의 조건과 이후 결과를 살핍니다. 이번 연구는 2008년부터 2023년까지 8개 의료기관의 자료를 사용했습니다. 연구 대상이 되는 시점과 예측하려는 1년 뒤 결과를 정하고, 기록에 있는 임상·사회·행동 변수를 모델 입력으로 구성했습니다.
이런 설계는 많은 사람의 실제 기록을 분석할 수 있다는 장점이 있습니다. 반면 처음부터 연구 목적으로 모든 변수를 같은 방식으로 측정한 자료가 아닙니다. 기록되지 않은 조건은 모델에 들어갈 수 없고, 누락된 값과 의료기관의 기록 관행이 결과에 영향을 줄 수 있습니다.
AUC 0.78은 무엇을 뜻하나
전체 11,809명 가운데 815명, 즉 6.9%가 1년 안에 연구가 정한 당뇨 기준에 도달했습니다. 비교한 모델 중 CatBoost의 평균 AUC가 0.78로 가장 높았습니다. AUC는 결과가 발생한 사례와 발생하지 않은 사례의 순서를 모델이 얼마나 잘 구분하는지 요약하는 지표입니다.
AUC 0.78은 모든 개인을 78% 정확도로 맞혔다는 말이 아닙니다. 실제 사용에서는 어느 점수부터 위험으로 분류할지 정해야 하고, 그 기준에 따라 놓치는 사례와 잘못 경고하는 사례의 수가 달라집니다. 이번 수치만으로 한 사람의 미래를 확정하거나 실제 현장의 오류 비율을 모두 설명할 수 없습니다.
SHAP은 모델 안의 설명 도구다
SHAP은 학습된 모델이 특정 예측을 만들 때 각 변수가 출력에 기여한 방향과 크기를 설명하는 방법입니다. 이번 연구에서는 이전 연도의 당화혈색소가 가장 영향력 있는 변수로 나타났습니다. 사회·행동 변수를 추가해도 전체 모델 성능은 유의하게 높아지지 않았고, 우울 관련 변수는 그 변수군 안에서 두드러졌습니다.
여기서 중요도는 모델이 기록 속 패턴을 이용한 정도입니다. 그 변수를 직접 바꾸면 결과가 달라진다는 인과 효과를 뜻하지 않습니다. 서로 연관된 변수 가운데 하나가 다른 변수의 정보를 대신 담을 수 있고, 기록되지 않은 조건이 양쪽에 영향을 줄 수도 있습니다.
예측 연관성과 원인 설명을 나누기
당화혈색소가 예측에 크게 기여했다는 결과는 모델이 이미 기록된 값을 유용하게 사용했다는 뜻입니다. 당화혈색소가 진행의 유일한 원인이라는 뜻은 아닙니다. 마찬가지로 우울 관련 변수가 사회·행동 변수군에서 두드러졌다는 사실도 우울이 진행을 일으켰다는 결론으로 바꿀 수 없습니다.
인과 효과를 묻는 연구라면 비교 집단, 시간 순서, 교란 요인 처리와 개입 조건을 별도로 설계해야 합니다. 예측모델은 미래 결과를 구분하는 데 초점을 두지만, 왜 그런 결과가 생겼는지를 자동으로 설명하지 않습니다.
변수를 더 넣어도 성능이 오르지 않을 수 있다
사회·행동 변수를 추가했지만 전체 성능이 유의하게 높아지지 않았다는 결과도 조심해서 읽어야 합니다. 이런 변수가 중요하지 않다는 뜻은 아닙니다. 의료 기록에 얼마나 완전하고 일관되게 남았는지, 변수 정의가 연구 질문과 맞는지에 따라 모델이 활용할 수 있는 정보가 달라집니다.
예측 성능의 변화가 작다는 결과와 사회적 조건의 실제 중요성은 같은 판단이 아닙니다. 모델은 제공된 데이터의 범위 안에서만 패턴을 학습합니다. 기록이 빈약한 영역은 실제 영향이 있어도 모델에 잘 드러나지 않을 수 있습니다.
다른 지역과 개인에게 옮길 때의 한계
자료는 미시간 남동부 한 지역 의료체계에서 나왔습니다. 환자 구성, 검사 빈도, 기록 방식이 다른 지역에서는 성능이 달라질 수 있습니다. 2008~2023년이라는 긴 기간 동안 의료 기록 관행과 인구 구성도 변했을 가능성이 있습니다.
후향 자료에는 측정되지 않은 교란과 결측이 남습니다. 모델의 평균 성능은 특정 개인의 확률이 정확하다는 보장이 아닙니다. 새로운 지역과 시기에 적용하려면 외부 자료에서 다시 검증하고, 선택한 분류 기준에서의 오류를 살펴야 합니다.
이 연구를 읽는 순서
먼저 대상이 누구였고 결과가 어떻게 정의됐는지 봅니다. 다음으로 AUC가 어떤 구분 성능을 요약하는지 확인합니다. 마지막으로 SHAP 중요도를 모델 내부의 예측 기여로 한정하고, 원인 설명과 분리합니다. 이 순서를 지키면 높은 점수와 보기 좋은 중요도 그래프를 개인 예후나 인과관계로 과장하는 일을 줄일 수 있습니다.
모델끼리의 순위도 같은 자료와 평가 절차 안에서 나온 비교로 한정해야 합니다. CatBoost가 이번 비교에서 가장 높은 평균 AUC를 보였다는 결과는 다른 의료체계의 모든 예측 과제에서 가장 좋은 모델이라는 뜻이 아닙니다. 데이터 구성과 결과 정의가 달라지면 비교 조건 자체가 달라집니다.
자주 묻는 질문
AUC 0.78이면 개인 예측이 충분히 정확한가요?
그 수치만으로 판단할 수 없습니다. 적용 기준과 오류 비율, 외부 검증이 함께 필요합니다.
SHAP 1위 변수는 질병의 가장 큰 원인인가요?
아닙니다. 학습된 모델 안에서 예측에 기여한 변수이며 인과 효과를 추정하지 않습니다.
사회·행동 변수가 성능을 높이지 못했다면 중요하지 않은가요?
그렇게 해석할 수 없습니다. 기록의 완전성과 변수 정의가 모델 활용도에 영향을 줍니다.
이 모델로 개인의 향후 상태를 확정할 수 있나요?
아닙니다. 한 지역의 후향 코호트 결과이며 다른 환경과 개인에 대한 확정 판단이 아닙니다.
출처와 이용 범위
이 글은 PubMed 연구 기록과 PMC 공개 자료의 사실만 독립적으로 요약했습니다. 원문의 문장, 표, 그림은 재사용하지 않았으며 개인의 진단이나 치료 판단을 제공하지 않습니다.