단백질 군집화에서 유사도 기준이 결과를 바꾸는 이유
딥러닝 서열 임베딩과 예측 구조 시대의 단백질 군집화를 구조 예측과 구분하고, 전체 서열·구조·국소 활성 부위 기준이 기능 주석에 미치는 영향을 설명합니다.
단백질 군집화에서 유사도 기준이 결과를 바꾸는 이유
제안 슬러그: protein-clustering-similarity-metrics-function-annotation
딥러닝으로 단백질 구조를 예측할 수 있는 시대에 단백질을 다시 군집으로 묶는 이유는 무엇일까요? 구조 예측은 개별 단백질이 어떤 형태를 가질지 추정하는 일입니다. 군집화는 많은 단백질 사이의 거리를 정하고 비슷한 것끼리 묶는 일입니다. 둘은 연결될 수 있지만 같은 과제가 아닙니다. 최근 문헌고찰은 서열 임베딩과 예측 구조가 넓힌 단백질 표현 공간에서 어떤 유사도 기준을 선택할지 살폈습니다. 문헌고찰
단백질 군집화는 무엇을 하려는가
단백질 군집화는 공통 진화 기원으로 서열이나 구조가 비슷한 단백질을 묶는 작업입니다. 기능이 잘 알려진 단백질과 덜 알려진 단백질이 같은 군집에 들어가면 기존의 특징과 주석을 살펴볼 단서가 생깁니다. 여기서 주석은 단백질이 어떤 기능과 관련되는지 정리한 정보입니다.
군집은 답 자체가 아니라 탐색 범위를 줄이는 지도에 가깝습니다. 같은 군집이라는 이유만으로 기능이 확정되지는 않습니다. 어떤 특징을 비교했고 어느 정도 가까워야 같은 군집으로 볼지에 따라 지도의 모양이 달라집니다.
구조 예측과 군집화의 차이
구조 예측은 한 단백질의 서열에서 입체적 접힘을 추정하는 문제입니다. 군집화는 여러 단백질의 표현을 비교해 관계를 묶는 문제입니다. 예측 구조를 군집화의 입력으로 쓸 수는 있지만, 구조가 있다는 사실만으로 비교 기준이 하나로 정해지는 것은 아닙니다.
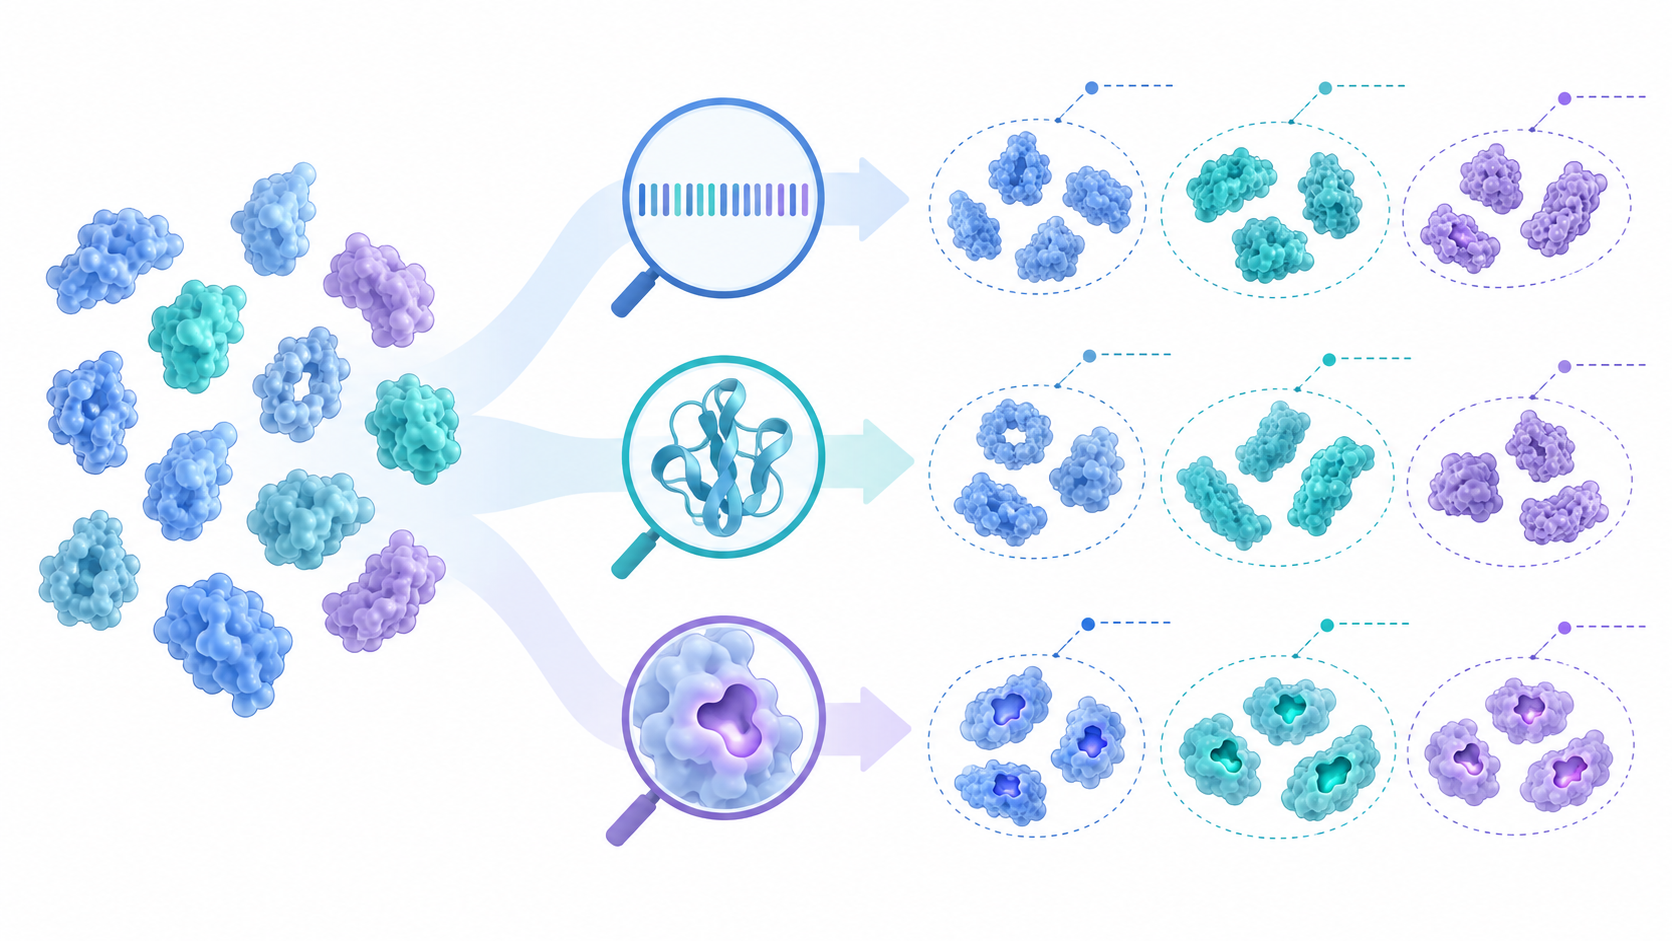
단백질 전체의 접힘이 비슷한지 볼 수도 있고, 작은 활성 부위의 모양과 물리적 환경을 비교할 수도 있습니다. 전체 구조는 비슷하지만 기능을 결정하는 국소 부위가 다를 수 있고, 전체 서열은 멀어도 중요한 부위가 비슷할 수 있습니다. 연구 목적에 따라 어느 차이를 더 중요하게 볼지가 달라집니다.
딥러닝은 무엇을 새로 제공했나
딥러닝은 단백질 서열을 고차원의 숫자 벡터로 바꾸는 임베딩과 예측 구조 같은 새로운 표현을 제공했습니다. 과거에는 실험으로 확인된 구조의 수가 제한돼 구조 비교의 범위도 제한됐습니다. 예측 구조가 늘면서 훨씬 큰 단백질 집합을 구조 관점에서 비교할 가능성이 생겼습니다. 딥러닝 표현 관련 연구
그러나 표현이 풍부해졌다고 어느 거리 함수가 생물학적으로 옳은지 자동으로 정해지는 것은 아닙니다. 임베딩 안의 가까움이 진화적 관계, 전체 구조 유사성, 특정 기능의 유사성 가운데 무엇을 가장 잘 반영하는지는 별도 평가가 필요합니다.
유사도 기준은 왜 군집을 바꾸나
서열 전체를 비교하면 아미노산 배열이 전반적으로 비슷한 단백질이 가까워집니다. 구조 전체를 비교하면 접힘이 비슷한 단백질이 묶일 수 있습니다. 활성 부위의 국소 환경을 비교하면 전체가 달라도 기능에 관여하는 작은 영역이 비슷한 단백질을 가까이 놓을 수 있습니다. 국소 환경 비교 연구
어떤 기준을 선택하느냐에 따라 군집의 경계와 크기가 달라집니다. 기능 주석을 옮기려는 목적이라면 그 기능과 관련된 특징을 제대로 반영하는 거리가 필요합니다. 진화적 관계를 탐색하는 목적과 활성 부위 후보를 찾는 목적이 같은 거리 기준을 요구한다고 볼 수 없습니다.
거리 기준뿐 아니라 같은 군집으로 묶는 임계값도 영향을 줍니다. 기준을 느슨하게 잡으면 큰 군집 안에 서로 다른 기능이 섞일 수 있고, 너무 엄격하게 잡으면 관계 있는 단백질이 작은 군집으로 쪼개질 수 있습니다. 따라서 군집이 선명하게 보인다는 시각적 인상만으로 좋은 분류라고 판단할 수 없습니다.
기능 주석이 불완전할 때 생기는 문제
군집의 품질을 평가하려면 비교할 기능 주석이 필요합니다. 그런데 기존 주석 자체가 불완전하거나 일부 단백질에 편중돼 있으면 평가 기준도 흔들립니다. 잘 연구된 단백질이 많은 군집은 해석하기 쉬운 반면, 덜 연구된 단백질이 모인 군집은 기능이 없어서가 아니라 기록이 부족해 평가하기 어려울 수 있습니다. 주석 공백 관련 연구
또 잘못된 주석을 군집 이웃에게 옮기면 오류가 확산될 수 있습니다. 군집 내 일관성이 높다는 결과가 사실은 기존 주석의 편향을 반복한 것인지도 확인해야 합니다. 외부 데이터와 독립 검증이 필요한 이유입니다.
군집에서 기능 설명으로 넘어가는 순서
첫째, 무엇을 찾으려는 군집인지 목적을 정해야 합니다. 둘째, 그 목적에 맞는 표현과 거리 기준을 선택해야 합니다. 셋째, 군집 경계가 다른 기준에서도 얼마나 안정적인지 확인해야 합니다. 넷째, 외부 주석과 비교하되 주석의 빈칸과 편향을 함께 살펴야 합니다. 마지막으로 중요한 기능 가설은 실험으로 검증해야 합니다.
이 순서는 군집화를 낮게 평가하려는 것이 아닙니다. 방대한 단백질 공간에서 후보를 정리하고 비교할 질문을 만드는 데 군집화는 유용합니다. 다만 구조 예측과 군집화, 기능 주석과 기능 증명을 각각 다른 단계로 구분해야 합니다.
자주 묻는 질문
구조가 비슷하면 기능도 같나요?
항상 그렇지는 않습니다. 전체 구조, 국소 활성 부위와 기능의 관계를 따로 살펴야 하며 실험 검증이 필요합니다.
딥러닝 임베딩이 기존 서열 비교보다 항상 낫나요?
목적과 평가 기준에 따라 다릅니다. 임베딩의 거리가 어떤 생물학적 관계를 반영하는지 검증해야 합니다.
군집이 뚜렷하면 기능 주석을 믿어도 되나요?
군집의 모양만으로 기능이 확정되지는 않습니다. 기존 주석의 완전성과 편향, 외부 자료와 실험 결과를 확인해야 합니다.
구조 예측 결과가 있으면 군집화는 필요 없나요?
두 과제는 다릅니다. 예측 구조는 개별 단백질의 표현을 제공하고 군집화는 많은 단백질의 관계를 정리합니다.
출처와 해석 범위
이 글은 대규모 단백질 군집화 문헌고찰, 국소 구조 환경 비교 연구, 기능 주석 공백 연구에서 확인되는 개념과 한계를 정리했습니다. 특정 군집의 기능이나 인과를 확정하지 않으며 원문 문장, 표, 그림은 재사용하지 않았습니다.