LLM으로 임상 기록을 구조화할 때 검증 설계가 먼저인 이유
수의학 23편과 사람 의료 31편의 정보 추출 연구를 비교한 범위 고찰을 바탕으로 데이터 준비, 주석, 오류 검토와 외부 검증의 역할을 설명합니다.
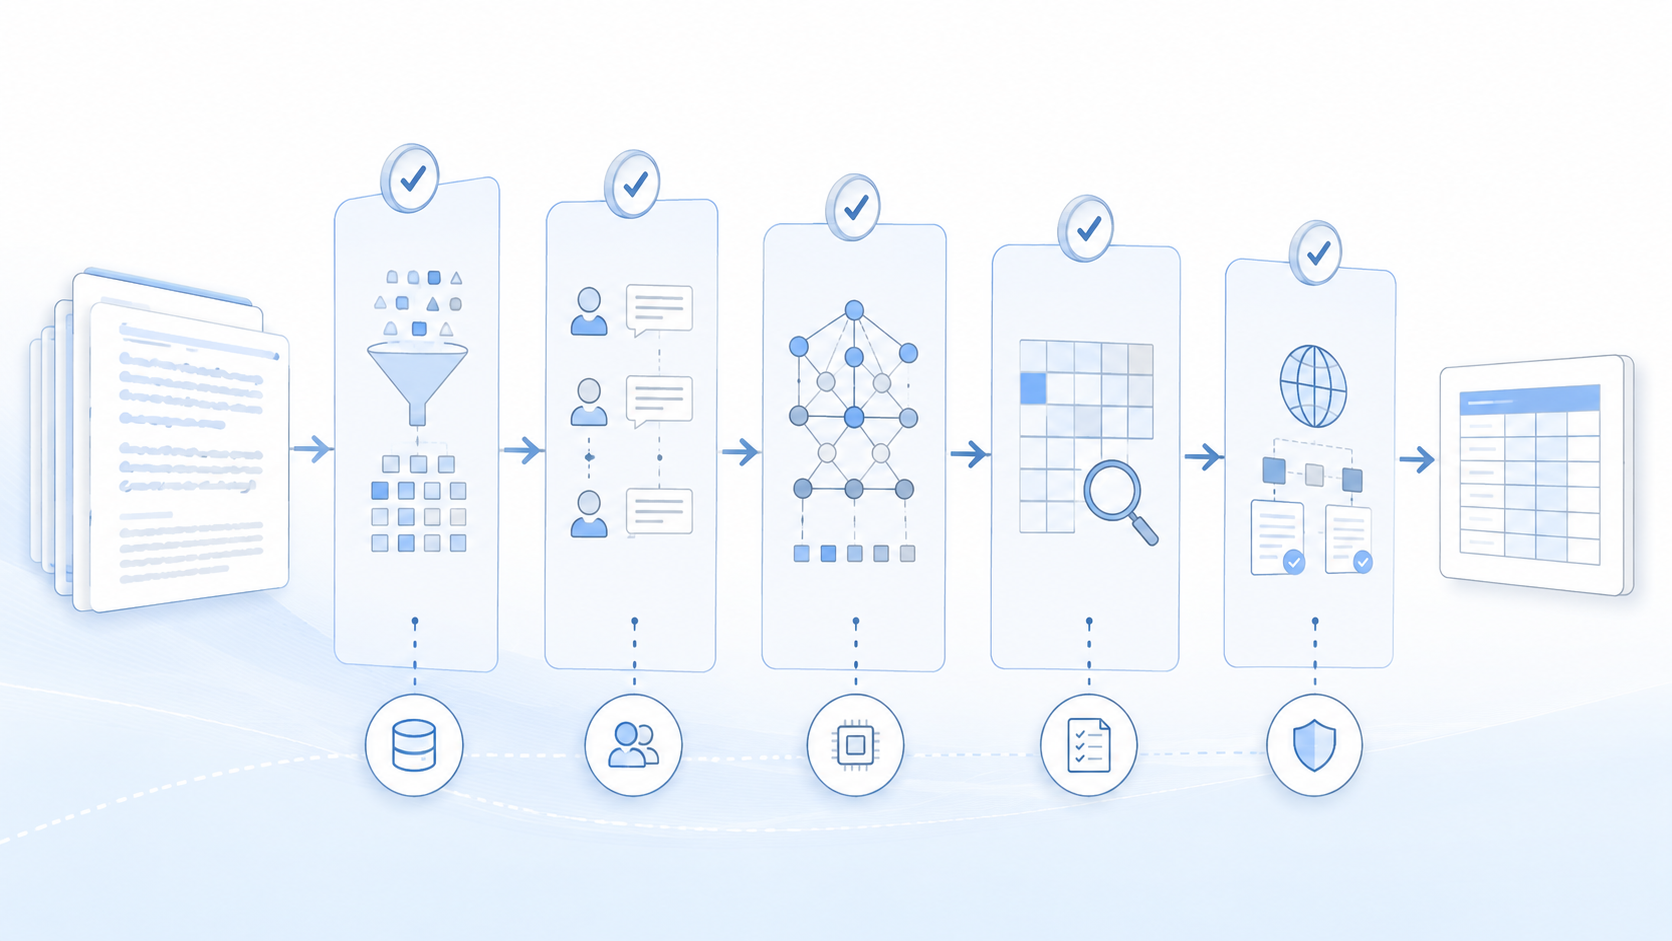
자유롭게 작성된 임상 기록을 LLM으로 구조화하려 할 때 모델 이름만 비교해서는 충분하지 않습니다. 어떤 기록을 모았고, 사람이 무엇을 정답으로 표시했으며, 오류를 어떻게 확인했는지가 달라지면 같은 기술도 다른 결과를 낼 수 있기 때문입니다. 수의학과 사람 의료의 정보 추출 연구를 비교한 범위 문헌고찰은 이 준비 과정의 차이를 정리했습니다. 범위 문헌고찰
5,796편에서 무엇을 골랐나
연구진은 PRISMA-ScR 지침에 따라 PubMed, CAB Abstracts, Web of Science와 ACL Anthology를 검색했습니다. 5,796편을 선별한 뒤 수의학 연구 23편과 사람 의료 연구 31편을 포함해 정보 추출 접근을 비교했습니다. 하나의 모델을 같은 데이터로 겨룬 실험이 아니라, 두 분야의 연구가 어떤 방식으로 기록에서 정보를 뽑았는지 살핀 범위 고찰입니다. 범위 문헌고찰
정보 추출은 자유서술 기록에서 필요한 항목을 찾아 구조화된 형태로 옮기는 작업을 가리킵니다. 이번 고찰의 비교 단위는 모델 하나의 점수보다 연구마다 준비한 데이터와 적용 방식에 가깝습니다.
지도학습과 프롬프트 기반 접근의 차이
고찰은 수의학 문헌에서 큰 데이터셋으로 학습한 지도학습 모델이 더 흔했다고 정리했습니다. 사람 의료 문헌에서는 더 작은 주석 데이터로 프롬프트 기반 LLM을 적용하는 연구가 늘어난 것으로 보고했습니다. 범위 문헌고찰
여기서 주석 데이터는 사람이 기록 안의 필요한 정보를 표시해 모델의 출력과 비교할 기준을 만든 자료입니다. 프롬프트 기반 접근은 미리 학습된 LLM에 지시와 예시를 제공해 원하는 정보를 꺼내는 방식으로 연구됐습니다. 두 방식은 필요한 데이터 양과 준비 과정이 다르므로, 연구 결과를 비교할 때 모델 이름만 보고 우열을 정하기 어렵습니다.
실제 적용 전에 검증 절차가 필요한 이유
수의학과 사람 의료는 기록의 내용과 데이터셋이 다르고, 포함된 연구의 설계도 서로 다릅니다. 이런 연구를 비교한 범위 고찰은 특정 LLM의 정확도를 보장하지 않습니다. 한 연구에서 작동한 추출 방식이 다른 기관의 기록에서도 같은 오류 양상과 성능을 보인다고 말할 수도 없습니다.
따라서 기록 구조화에서는 데이터 준비, 개인정보 보호, 오류 검토와 외부 검증을 모델 선택과 별개의 단계로 다뤄야 합니다. 이 문헌고찰이 보여주는 것은 어느 모델을 채택하라는 결론이 아니라, 적용 환경에 맞는 자료와 검증 절차 없이 모델 성능만 옮겨 읽기 어렵다는 점입니다. 범위 문헌고찰
범위 고찰은 모델 순위표가 아니다
이 연구는 수의학 23편과 사람 의료 31편을 포함했지만, 모든 연구가 같은 기록과 같은 정답, 같은 평가 방식으로 모델을 비교한 것은 아닙니다. 연구 분야와 데이터셋이 다르다는 한계가 명시돼 있습니다. 따라서 포함된 연구 수가 많다는 이유로 특정 모델이 두 분야에서 공통으로 우수하다고 결론 내릴 수 없습니다. 범위 문헌고찰
범위 고찰이 보여주는 것은 어떤 접근이 어느 분야의 문헌에서 더 흔하게 사용됐는지입니다. 수의학에서 큰 데이터셋으로 학습한 지도학습 모델이 흔했고, 사람 의료에서는 작은 주석 데이터와 프롬프트 기반 LLM 연구가 늘었다는 결과도 사용 경향에 관한 비교입니다. 같은 조건에서 정확도를 겨룬 결과로 바꾸어 읽어서는 안 됩니다.
데이터 준비가 모델보다 앞에 놓이는 이유
지도학습 연구에서는 학습에 사용할 큰 데이터셋이 언급됐고, 프롬프트 기반 연구에서도 비교 기준이 되는 주석 데이터가 사용됐습니다. 접근은 다르지만 기록에서 어떤 정보를 꺼낼지 정하고, 사람이 확인할 기준을 마련해야 한다는 점은 결과를 해석하는 데 중요합니다. 데이터 준비가 다르면 모델 출력의 비교 조건도 달라집니다. 범위 문헌고찰
주석 자료가 작다는 사실도 단순히 적은 비용이나 빠른 적용을 뜻하지 않습니다. 어떤 항목을 표시했는지와 표시가 일관적인지, 그 자료가 적용할 기록을 충분히 나타내는지는 별도 검토가 필요합니다. 이번 고찰은 특정 주석 방식 하나의 우수성을 검증하지 않았습니다.
오류 검토와 외부 검증을 분리하기
모델이 기존 자료에서 정보를 잘 추출했더라도 새로운 기관이나 다른 종류의 기록에서 같은 결과를 낸다고 보장할 수 없습니다. 이번 고찰은 실제 의료 환경의 안전성을 보장하지 않으며 외부 검증이 별도로 필요하다고 정리했습니다. 범위 문헌고찰
오류 검토는 모델이 놓치거나 잘못 구조화한 항목을 확인하는 단계이고, 외부 검증은 처음 개발에 사용한 조건 밖에서도 결과가 유지되는지 살피는 단계로 구분해 볼 수 있습니다. 이 글은 그 구체적인 수행법이나 기준값을 제안하지 않습니다. 다만 모델 선택 하나로 두 검증이 대체되지 않는다는 근거 범위를 유지합니다.
개인정보 보호도 정확도와 다른 축입니다. 원하는 항목을 추출할 수 있다는 사실이 기록을 안전하게 처리했다는 뜻은 아닙니다. 어떤 데이터를 사용하고 누가 접근하는지에 관한 보호 절차는 모델 성능과 별도로 확인해야 합니다.
적용 전에 물어야 할 질문
먼저 추출하려는 항목과 사람이 확인할 기준이 무엇인지 분명해야 합니다. 다음으로 개발에 사용한 기록과 실제 적용할 기록이 어떻게 다른지 확인해야 합니다. 마지막으로 오류를 누가 검토하고 새로운 환경에서 어떻게 다시 검증할지 정해야 합니다.
이 질문들은 특정 LLM을 추천하기 위한 목록이 아닙니다. 범위 고찰이 비교한 문헌의 차이를 실제 적용 판단과 혼동하지 않기 위한 읽기 순서입니다. 구체적인 모델 성능과 안전성은 해당 데이터와 환경에서 별도로 검증해야 합니다.
자주 묻는 질문
프롬프트 기반 LLM이 지도학습 모델보다 낫다는 결과인가요?
아닙니다. 고찰은 두 분야 문헌에서 흔한 접근이 달랐다고 정리했으며, 같은 데이터로 우열을 비교하지 않았습니다.
작은 주석 데이터만 있으면 바로 적용할 수 있나요?
그렇게 말할 수 없습니다. 데이터 준비, 오류 검토, 개인정보 보호와 외부 검증이 별도로 필요합니다.
한 기관의 기록에서 정확하면 다른 기관에서도 정확한가요?
보장할 수 없습니다. 데이터셋과 기록 환경이 다르므로 외부 검증이 필요합니다.
LLM 추출 결과를 임상 판단에 바로 사용할 수 있나요?
이 고찰은 그런 안전성이나 타당성을 확정하지 않습니다. 정보 추출 접근의 문헌 경향을 비교한 연구입니다.
출처와 근거의 경계
이 글은 수의학·사람 의료 임상 기록의 정보 추출 연구를 비교한 범위 문헌고찰을 설명합니다. 특정 LLM의 정확도, 실제 의료 환경의 안전성 또는 임상 판단 가능성은 이 자료로 확정하지 않습니다.